Warum eine 5×5-Risikomatrix Risiken in die falsche Reihenfolge bringt
Die Risikomatrix ist das meistbenutzte Werkzeug im Risikomanagement. Und sie ist mathematisch kaputt.
Das ist ein hartes Urteil über ein Instrument, das in fast jedem Sicherheitsbericht, jedem Audit und in jeder Vorstandsvorlage steckt. ie vertraute Ampel aus grünen, gelben und roten Feldern, in die man die Risiken einordnet. Ich behaupte hier nicht, dass die Menschen, die sie benutzen, etwas falsch machen. Ich behaupte nur, dass das Werkzeug sie alle täuscht. Und das lässt sich vorrechnen.
Wie die Matrix funktioniert
Das Prinzip ist bestechend einfach, und darin liegt der Reiz. Man bewertet jedes Risiko auf zwei fünfstufigen Skalen: Wie wahrscheinlich ist es? Und. Wie schwer wäre der Schaden? Von „Sehr selten“ bis „fast sicher“, von „gering“ bis „existenzbedrohend“. Dann multipliziert man die beiden Stufenzahlen. Zum Beispiel: Eine Wahrscheinlichkeit der Stufe 4 mal ein Schaden der Stufe 2 ergibt einen Risiko-Score von 8. Die Farbe des Feldes — grün, gelb, orange, rot — folgt dann aus diesem Produkt.
Das Ergebnis ist ein Bild, das jeder sofort versteht: Rote Felder oben rechts sind schlimm, grüne unten links harmlos. Man sieht auf einen Blick, worum man sich kümmern muss. Genau diese offensichtliche Anschaulichkeit hat die Matrix zum Gold-Standard gemacht. Allerdings: Genau in ihr steckt auch der Fehler.
Zwei Risiken, eine falsche Reihenfolge
Nehmen wir zwei konkrete Risiken, wie sie in jeder Organisation vorkommen könnten.
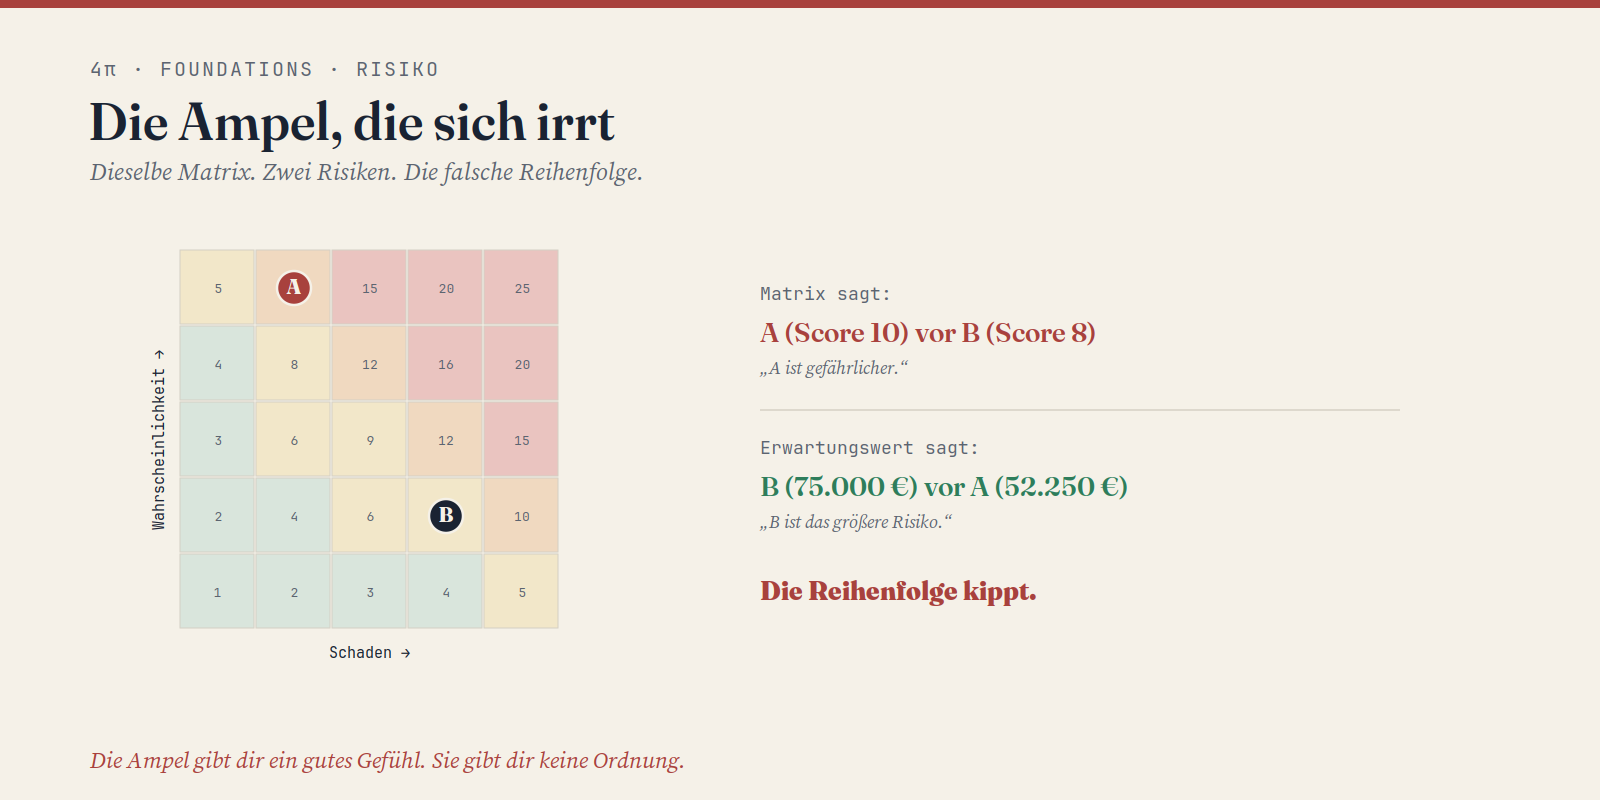
Risiko A — eine Phishing-Welle. So etwas passiert häufig; sagen wir, mit 55 Prozent Wahrscheinlichkeit im Jahr. Der Schaden pro Fall ist spürbar, aber begrenzt: rund 95.000,- Euro. Damit landen wir auf den Skalen bei: Wahrscheinlichkeit Stufe 5, Schaden Stufe 2. Matrix-Score: 5 × 2 = 10.
Risiko B — Ransomware auf der Kern-Datenbank. So etwas ist eher selten; sagen wir, 5 Prozent im Jahr. Aber wenn es passiert, ist der Schaden schon existenznah: rund 1,5 Millionen Euro. Auf den Skalen landen wir dann bei: Wahrscheinlichkeit Stufe 2, Schaden Stufe 4. Matrix-Score: 2 × 4 = 8.
Das Ergebnis in der Matrix ist eindeutig: A hat den höheren Score (10 gegenüber 8). A liegt im roten Feld. Wer dann der Matrix folgt, kümmert sich zuerst um A. Also um die Phishing-Welle.
Jetzt rechnen wir einmal das tatsächliche Risiko aus, so wie man es seit Jahrhunderten in der Versicherungsbranche in ähnlicher Weise tut: Wahrscheinlichkeit mal Schaden, der erwartete Jahresverlust. Für A: 0,55 × 95.000 = rund 52.000 Euro. Für B: 0,05 × 1.500.000 = 75.000 Euro.
Die Reihenfolge kippt. In Wahrheit ist B das größere Risiko. Es kostet erwartungsgemäß fast anderthalbmal so viel wie A. Die Matrix hat also die Prioritäten vertauscht. Wer ihr folgen würde, investiert zuerst ins Phishing-Training, während das größere Risiko, die Ransomware, hintenansteht.
Die Matrix sagt: A vor B. Der Erwartungswert sagt: B vor A. Beide können nicht recht haben.
Warum das passiert und warum es kein Zufall ist
Man könnte meinen, ich hätte die Zahlen gezielt so gewählt, dass es schiefgeht. Das habe ich, aber nur, um es sichtbar zu machen. Der Effekt selbst ist systematisch, und er hat zwei Ursachen. Beide stecken in der Konstruktion der Matrix.
Erstens: Kompression. Die fünf Stufen werfen Information weg. Ein Schaden von 95.000,- Euro landet in Stufe 2, einer von 1,5 Millionen in Stufe 4. Aber diese beiden Beträge liegen um den Faktor 16 auseinander. Die Matrix übersetzt diesen gewaltigen Unterschied in einen Stufenabstand von gerade einmal 2. Sobald man einen Betrag in eine Stufe presst, ist seine tatsächliche Größe verloren. Zwei Risiken, die sich real um eine Größenordnung unterscheiden, können in derselben Stufe landen und sind damit für die Matrix ununterscheidbar.
Zweitens: die Multiplikation von Rangzahlen. Und das ist der tiefere, subtilere Fehler. Die Stufen 1 bis 5 sind ordinale Zahlen, und repräsentieren Rangplätze und keine Messwerte. Stufe 4 bedeutet „schlimmer als Stufe 3“, aber nicht „doppelt so schlimm wie Stufe 2“. Man darf mit Rangzahlen rechnen wie mit Platzierungen bei einem Wettkampf: Der Vierte kam nach dem Zweiten ins Ziel. Aber „4 geteilt durch 2“ ergibt keinen Sinn, denn, der Vierte war nicht „halb so schnell“. Genau das tut aber die Matrix, wenn sie 4 × 2 rechnet und mit 2 × 4 vergleicht. Sie multipliziert Ordnungszahlen, als wären es Beträge. Das ist mathematisch schlicht nicht erlaubt. Dass beide Produkte 8 ergeben, ist ein Rechenartefakt, keine Aussage über die Wirklichkeit.
Diese beiden Effekte zusammengenommen, die Kompression und die ordinale Multiplikation, sorgen dafür, dass die Matrix die Rangfolge von Risiken verdrehen kann. Nicht immer, aber oft genug, um wirklich gefährlich zu sein.
Wer noch ein vertrautes Bild möchte: Denken wir an Schulnoten. Eine Zwei ist besser als eine Vier, aber niemand würde behaupten, ein Schüler mit einer Zwei sei „doppelt so gut“ wie einer mit einer Vier. Die Noten sind Rangplätze, keine Messwerte; der Abstand zwischen Eins und Zwei muss nicht dem Abstand zwischen Vier und Fünf entsprechen. Genau deshalb bildet man aus Noten einen Durchschnitt mit großer Vorsicht und würde sie niemals miteinander multiplizieren. Die Risikomatrix aber tut genau das mit ihren Stufen, ganz selbstverständlich und in jeder Zelle. Der Fehler ist derselbe. Er fällt nur nicht auf, weil das Ergebnis so ordentlich aussieht.
Wie oft irrt sie? Öfter, als man denkt
Man kann diese Frage empirisch beantworten, statt sie dem Bauchgefühl zu überlassen. Man erzeugt 200.000 zufällige Risikopaare. Jedes mit einer Wahrscheinlichkeit und einem Schaden aus realistischen Bereichen und vergleicht für jedes Paar zwei Dinge: Wie ordnet die 5×5-Matrix die beiden ein, und wie verordnet sie der tatsächliche Erwartungswert?
Das Ergebnis: In rund 8 Prozent aller unterscheidbaren Paare widerspricht die Matrix dem Erwartungswert und stuft das kleinere Risiko als das größere ein oder umgekehrt. Jedes zwölfte Paar also. Das ist kein exotischer Grenzfall, den man konstruieren muss. Es ist ein struktureller Defekt der Matrix, der bei ganz normalen Risiken zuschlägt. Und weil niemand die Matrix gegen den Erwartungswert prüft, weil man vertraut ihr ja, bleibt dieser Fehler unsichtbar. Man merkt nicht, dass man unter Umständen die falschen Dinge zuerst tut.
Woher das kommt: Es ist kein Bauchgefühl, sondern ein formaler Beweis
Der Effekt ist nicht neu, und man muss ihn sich nicht ausdenken. Er wurde 2008 von Louis Anthony Cox in der Fachzeitschrift Risk Analysis, in einem der meistzitierten Papers der quantitativen Risikoforschung mit dem Titel „What’s Wrong with Risk Matrices?“ mathematisch bewiesen. Cox zeigte, dass eine Risikomatrix grundsätzlich nur einen kleinen Teil zufällig gezogener Gefahrenpaare korrekt und eindeutig ordnen kann und dass sie einem quantitativ kleineren Risiko eine höhere Stufe geben kann als einem größeren. In der Literatur heißt dieses Phänomen Rank Reversal, die Rangumkehr.
Die 200.000 Paare sind also kein fremdes Laborexperiment, das man glauben muss, sondern die empirische Bestätigung von Cox‘ Theorem: Die Simulation macht sichtbar und zählbar, was Cox algebraisch hergeleitet hat. Jeder kann sie in wenigen Zeilen Code selbst nachrechnen.
Die Ursache benennt Cox als den Elementarfehler, nämlich die Verwechslung von Ordinal- mit Kardinalzahlen. Die Matrix macht aus kontinuierlichen Zahlen fünf grobe Ränge und multipliziert diese Ränge miteinander. Beim Multiplizieren zweier gerundeter Kategorien geht die Ordnung der echten Produkte aber teilweise verloren. Genau dort entsteht die Rangumkehr.
Was die 8 Prozent bedeuten — und was nicht
Ein ehrlicher Zusatz gehört hier genannt: Die konkrete Prozentzahl ist keine Naturkonstante. Sie hängt davon ab, über welche Bereiche man Wahrscheinlichkeiten und Schaden zieht. In der Simulation streuen beide über mehrere Größenordnungen. Die Wahrscheinlichkeit von 0,0001 bis 1, der Schaden von 100,- Euro bis 100 Millionen Euro, beide logarithmisch, weil reale Risiken ebenso streuen. Variiert man diese Bereiche, liegt das Ergebnis etwa zwischen 7 und 10 Prozent. Die Größenordnung bleibt dabei in etwa stabil und die Aussage von Cox, nur ein Bruchteil aller Paare wird korrekt geordnet, erst recht. Deshalb gehören die Annahmen immer dazu, wenn man die Zahlen nennt.
Und die Rangumkehr ist nur der eine Defekt. In weiteren rund 8 Prozent der Fälle trifft die Matrix gar keine Aussage, weil beide Risiken in Zellen mit demselben Score landen. Sie kann quantitativ verschiedene Risiken dann nicht mehr auseinanderhalten. Das ist der zweite blinde Fleck neben dem ersten.
Das Werkzeug täuscht und nicht der Anwender
Mir ist wichtig, das ganz klar zu sagen: Wer Risikomatrizen benutzt, ist nicht naiv oder schlecht ausgebildet. Die Matrix ist populär, weil sie echte Bedürfnisse erfüllt. Sie ist schnell, anschaulich, kommunizierbar und sie zwingt dazu, überhaupt über Wahrscheinlichkeiten und Schaden getrennt nachzudenken. Das sind echte Tugenden. Der Fehler liegt nicht bei den Menschen, die sie einsetzen, sondern in der stillschweigenden Annahme, die im Werkzeug selbst steckt: Nämlich, dass man Stufen miteinander multipliziert werden dürfen, als wären es echte Größen.
Es ist ein bisschen wie mit einer Uhr, die falsch geht. Man kann nicht der Person die Schuld geben, die auf sie schaut. Man muss die Uhr richten oder eine bessere verwenden. Und die Ehrlichkeit nötigt uns zu einem Eingeständnis: Die Matrix geht falsch, gerade weil sie so bequem abzulesen ist.
Was man stattdessen tun sollte
Die gute Nachricht ist: Die Alternative muss nicht komplizierter sein, sondern nur ehrlicher. Der entscheidende Schritt ist, damit aufzuhören, Wahrscheinlichkeiten und Schaden in Stufen reinpressen zu wollen und sie stattdessen als das zu behandeln was sie auch sind: Größen, mit denen man rechnen darf.
Statt „Schaden Stufe 2“ schätzt man einen Bereich: Sagen wir, zwischen 50.000,- und 200.000,- Euro, mit einem wahrscheinlichsten Wert dazwischen. Statt „Wahrscheinlichkeit Stufe 4“ schätzt man eine Spanne. Und dann rechnet man. Nicht mit Rangzahlen, sondern mit den Beträgen selbst. Das Ergebnis ist keine Ampelfarbe mehr, sondern eine Zahl in Euro, die man gegen ein Budget, eine Rücklage, eine Risikotragfähigkeit halten kann. Und weil Schätzungen unsicher sind, rechnet man nicht mit einem einzigen Wert, sondern mit der ganzen Wert-Bandbreite. Man liest ab, welchen Verlust man mit welcher Wahrscheinlichkeit nicht überschreiten wird.
Das ist keine exotische Wissenschaft. Es ist die Art und Weise, wie Versicherungen, Banken und die Ingenieurdisziplinen seit vielen Jahrzenten mit dem Risiko umgehen: quantitativ, mit Verteilungen anstelle von Farben. Und es ist der Kern dessen, woran ich arbeite. Wie kann man Risiken so bewertet, dass die Zahlen am Ende halten. Aber das ist ein eigenes, großes Thema. Dazu kommt bald viel mehr.
Um aber die Richtung schon zu zeigen: Unsere beiden Risiken von vorhin sähen quantitativ behandelt völlig anders aus. Statt „A ist Stufe 10, B ist Stufe 8“ stünde da: A hat einen erwarteten Jahresverlust von rund 52.000,- Euro, aber eine wehr enge Spanne. Der Schaden schwankt also nicht dramatisch. B hat einen erwarteten Verlust von 75.000,- Euro, aber eine völlig andere Gestalt: In den allermeisten Jahren kostet B gar nichts, und in dem einen seltenen Jahr kostet es 1,5 Millionen. Diese beiden Risiken sind nicht nur unterschiedlich groß, sie sind unterschiedlich geformt. Genau diese Form ist es, die über die richtige Reaktion entscheidet. Gegen A hilft ein laufendes Programm, gegen B hilft nur eine Rücklage oder eine geeignete Versicherung. Die Matrix kann diesen Unterschied nicht einmal annähernd ausdrücken. Eine Verteilung kann es aber.
Man erkennt daran, was die Ampel alles wegwirft: nicht nur die Reihenfolge, sondern aucg die gesamte Struktur des Risikos. Zwei Zahlen und eine Farbe können nicht abbilden, ob ein Risiko ein stetiges Rinnsal oder eine seltene Flut ist. Und diese Unterscheidung ist oft wichtiger als die Rangfolge selbst. Stichwort: Angemessene Maßnahmen.
Die dritte Falle: Farbe verführt
Es gibt noch einen Effekt, der subtiler ist als die Kompression und die ordinale Multiplikation und ist damit vielleicht der gefährlichste. Er steckt nämlich nicht in der Rechnung selbst, sondern in unseren Köpfen. Farbe wirkt wie eine Aussage über die Wirklichkeit, obwohl sie nur eine selbst gewählte Konvention ist.
Wo die Grenze zwischen Gelb und Rot verläuft, ist keine Eigenschaft des Risikos. Es ist eine Entscheidung von demjenigen, der die Matrix gebaut hat. Verschiebt man die Schwelle um ein einziges Feld, wandern Risiken von „akzeptabel“ zu „handlungsbedürftig“, ohne dass sich an ihnen irgendetwas geändert hätte. Zwei Organisationen mit identischen Risiken und leicht verschieden kolorierten Matrizen kommen zu gegensätzlichen Prioritäten. Und niemand merkt es, weil die Farbe so überzeugend aussieht. Ein roter Block fühlt sich an wie eine Tatsache. Er ist aber eine Designentscheidung.
Diese scheinbare Objektivität ist der eigentliche Grund, warum die Matrix so schwer zu hinterfragen ist. Eine Zahl lädt zum Nachrechnen ein. Eine Farbe lädt zum Glauben ein. Und Glaube ist in der Risikobewertung ein schlechter Ratgeber.
Hinzu kommt eine trügerische Präzision. Fünf mal fünf Felder ergeben fünfundzwanzig Kästchen und Scores von 1 bis 25-. Das sieht fein aufgelöst aus und nach einer differenzierten Bewertung. Tatsächlich sind viele dieser Scores gar nicht erreichbar oder mehrfach belegt, und die scheinbare Genauigkeit einer Zahl wie „12“ steht in keinem Verhältnis zur Grobheit der zugrundeliegenden Stufen. Die Matrix verspricht eine Auflösung, die sie aber nicht halten kann. Sie ist ein grobes Werkzeug im Kostüm eines Präzisionsgerätes.
Warum sie sich trotzdem durchgesetzt hat
Wenn die Matrix so fehleranfällig ist, warum ist sie dann überall in Verwendung? Die Antwort ist eine Kette nachvollziehbarer Anreize, und es lohnt sich, sie ehrlich anzusprechen.
Die Matrix löst ein echtes Problem: Sie zwingt dazu, Wahrscheinlichkeiten und Schaden überhaupt einmal getrennt zu betrachten. Das alleine ist schon ein großer Fortschritt gegenüber dem bloßen Bauchgefühl „das ist gefährlich“. Sie liefert ein Bild, das man in dreißig Sekunden einem Vorstand erklären kann. Sie verlangt keine Daten, keine Schätzung von Beträgen, keine Rechnung. Nur ein Einordnen in Stufen, das sich jeder zutraut. Und sie erzeugt ein Gefühl von Kontrolle und Vollständigkeit: Alle Risiken sind eingetragen, alle Felder gefüllt, das Bild ist bunt und sieht gründlich aus.
Das sind reale Vorzüge, und sie erklären den Erfolg. Aber sie erklären ihn als Erfolg der Kommunikation, nicht der Analyse. Die Matrix ist ein hervorragendes Darstellungswerkzeug aber ein denkbar schlechtes Entscheidungswerkzeug. Der Fehler beginnt in dem Moment, in dem man aufhört, sie nur zum Herzeigen zu benutzen, und anfängt, an sie zu glauben.
Woher wir das wissen
Die Kritik an der Risikomatrix ist nicht meine Erfindung und keine Geschmacksfrage. Sie ist seit über anderthalb Jahrzehnten sauber ausgearbeitet. Die grundlegende Analyse, dass ordinale Risikomatrizen Rangfolgen verletzen und „schlechter als zufällig“ sein können, stammt aus der peer-reviewten Fachliteratur des Risikomanagements. Was ich hier gezeigt habe, ist nur die nachrechenbare Spitze davon: zwei Risiken, ein Widerspruch, den jeder mit denselben Zahlen reproduzieren kann.
Das ist der Punkt, und er ist größer als die Matrix. Eine Aussage, die man nachrechnen kann, hat eine Adresse: Wer ihr widersprechen will, muss zeigen, an welcher Stelle die Rechnung falsch ist und es genügt nicht bloß zu sagen, dass er es „anders sieht“. Die Ampel gibt einem diese Möglichkeit nicht. Sie gibt ein Gefühl von Ordnung wieder, das sich der Überprüfung allerdings entzieht. Und ein Gefühl von Ordnung ist genau das, was man in der Sicherheit nicht gebrauchen kann.
Die Ampel gibt dir ein gutes Gefühl. Sie gibt dir keine Ordnung.
Nutzt ihr die Risikomatrix noch zur Priorisierung oder rechnet ihr schon? Ich bin gespannt auf eure Erfahrungen.
Quellen
Primärquelle Cox, L. A. (Tony) Jr. (2008): „What’s Wrong with Risk Matrices?“, Risk Analysis 28(2), S. 497–512. DOI 10.1111/j.1539-6924.2008.01030.x. Der mathematische Beweis der Rangumkehr, der begrenzten Auflösung und der Möglichkeit schlechter-als-zufälliger Entscheidungen. https://onlinelibrary.wiley.com/doi/abs/10.1111/j.1539-6924.2008.01030.x
Formale Herleitung Quintino, A. u. a.: „What’s Wrong with Risk Matrices? — Decoding a Louis Anthony Cox paper.“ Schritt-für-Schritt-Nachvollzug der Konsistenz-Lemmata und der Färbungsregeln. https://www.researchgate.net/publication/310802191
Einordnung Talbot, J.: „What’s right with risk matrices?“ Ausgewogene Gegenposition, die Cox’ Kritikpunkte anerkennt und den sinnvollen Einsatzbereich der Matrix absteckt. https://www.juliantalbot.com/post/2018/07/31/whats-right-with-risk-matrices
Die Simulation in diesem Dokument ist eine eigenständige Reproduktion des in der Primärquelle bewiesenen Effekts, keine Übernahme fremder Zahlen.