Warum Cyberschäden lognormal sind und was das für Risikozahlen bedeutet
Der durchschnittliche Cyberschaden ist eine Zahl, die fast nie eintritt.
Das klingt nach einem Widerspruch, ist aber eine direkte Folge davon, wie Schäden entstehen. Und es hat eine unbequeme Konsequenz: Der Wert, der in den meisten Risikoberichten ganz oben steht, beschreibt oft weder den typischen Vorfall noch die gefürchtete Katastrophe sondern irgendeinen Punkt dazwischen, den man in der Realität allerdings sehr selten antrifft. Sehen wir uns an, warum das so ist und was man stattdessen wirklich benötigen würde.
Die stille Default-Annahme
In den meisten Risikoberichten steht eine einzige einzelne Zahl: der erwartete Schaden, häufig flankiert von einer Standardabweichung. Beide Kennzahlen stammen aus der Welt der Normalverteilung, der Gauß`schen Glockenkurve. Sie ist symmetrisch: Durchschnitt und Median liegen bei dieser Verteilung beide in der Mitte der Verteilung. Sie fallen also zusammen. Median ist gleich Durschnitt.
Diese Annahme wird allerdings fast nie konkret an- oder ausgesprochen. Sie steckt immer implizit in jedem „Mittelwert plus/minus Standardabweichung“ drinnen. Und damit in jeder Kennzahl, die einen Schaden mit einer einzigen Zahl beschreibt. Für Körpergrößen, Messfehler oder Würfelsummen ist die Glockenkurve ein hervorragendes Modell. Für Cyberschäden ist sie schlichtweg das falsche Werkzeug. Der Fehler ist dabei allerdings kein kleiner, sondern ein systematischer.
Warum Schäden anders entstehen
Der Unterschied liegt in der Entstehung. Eine Körpergröße ist die Summe vieler kleiner, unabhängiger Einflüsse: Gene, Ernährung, Schlaf, hunderte Faktoren, die sich addieren. Und die Summe vieler unabhängiger Zufallseinflüsse führt, das ist ein tiefes Resultat der Statistik, fast zwangsläufig zur Glockenkurve. Deshalb ist sie überall dort ein gutes Modell, wo sich Dinge aufsummieren.
Cyberschäden addieren sich nicht. Sie eskalieren entlang einer Kette, in der jeder Schritt den vorigen vervielfacht: die Zahl der betroffenen Systeme, mal die Ausfalldauer, mal der Wiederherstellungsaufwand pro System, mal die regulatorischen und Reputationsfolgen. Verdoppelt sich nur einer dieser Faktoren, verdoppelt sich damit auch der Gesamtschaden. Er wächst nicht nur um einen festen Betrag, sondern um den entsprechenden Faktor.
Und wo sich viele Faktoren multiplizieren statt aufzusummieren, entsteht keine symmetrische Kurve. Es entsteht eine stark rechtsschiefe Verteilung: die meisten Vorfälle bleiben klein, aber ein langer Schwanz seltener, sehr teurer Ereignisse zieht sich nach rechts. Diese Verteilung hat einen Namen: Die Lognormalverteilung. Der Name verrät auch schon, warum sie entsteht: Nimmt man den Logarithmus eines multiplikativen Prozesses, wird aus dem Produkt eine Summe und die Summen führen zur Glockenkurve. Der Logarithmus des Schadens ist normalverteilt. Der Schaden selbst ist es nicht.
Diese Verteilung ist übrigens keine Spezialität der Cybersicherheit. Sie beschreibt z.B. die Einkommensverteilung, die Dauer von Krankheiten und viele biologische Prozesse: Überall, wo Wachstum multiplikativ verläuft, taucht sie auf. Cyberschäden sind nur ein weiteres Mitglied einer sehr großen Familie.
Erst ein Begriffshinweis
Bevor wir zur eigentlichen Pointe kommen, müssen drei Wörter sauber getrennt werden, die im Alltag gern durcheinandergeraten.
Durchschnitt, Mittelwert und Erwartungswert meinen dasselbe: alle Werte zusammengezählt und durch ihre Anzahl geteilt. Beziehungsweise das theoretische Gegenstück davon für eine Verteilung. Es ist der „Schwerpunkt“ der Verteilung, der Punkt, an dem sie balancieren würde.
Der Median ist etwas anderes: der Wert genau in der Mitte, wenn man alle Fälle der Größe nach sortiert. Die Hälfte liegt darüber, die Hälfte darunter. Man nennt ihn auch das 50. Perzentil.
Bei einer symmetrischen Verteilung fallen Median und Durchschnitt zusammen. Deshalb verwechselt man sie so leicht, denn bei der Glockenkurve sind sie tatsächlich identisch. Bei einer schiefen Verteilung trennen sie sich. Und genau diese Trennung ist der springende Punkt.
Es lohnt sich, diese Trennung nicht als technisches Detail abzutun. Sie ist der Grund, warum zwei Fachleute mit denselben, korrekten Zahlen zu völlig verschiedenen Einschätzungen kommen können. Der eine nennt den Median und meint den typischen Fall, der andere nennt den Durchschnitt und meint das erwartete Mittel. Beide haben recht, beide reden über dasselbe Datenmaterial, und trotzdem reden sie vortrefflich aneinander vorbei. Wer die beiden Begriffe nicht sauber trennt, produziert genau solche Scheindebatten.
Median und Durchschnitt fallen auseinander
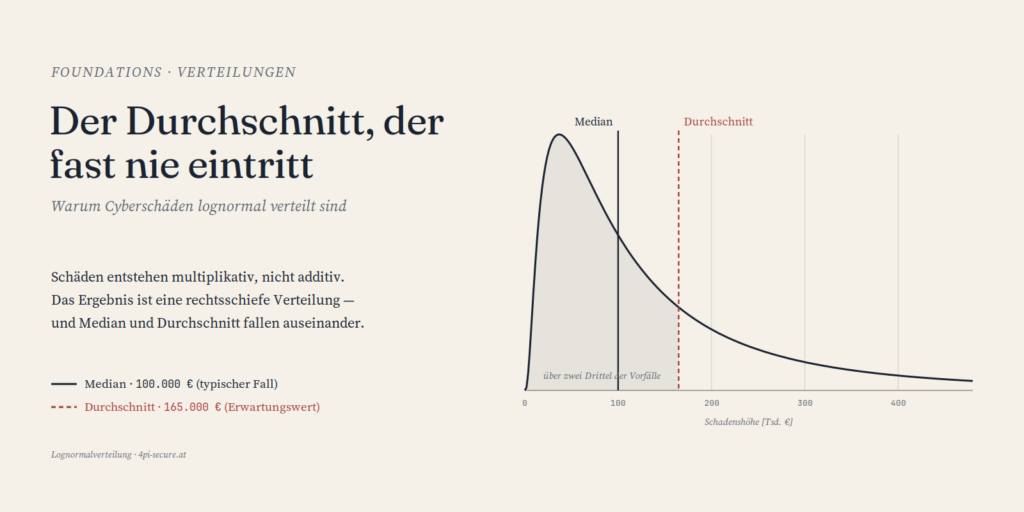
Machen wir es an Zahlen konkret. Nehmen wir an, der typische Vorfall und damit der Median, kostet 100.000 Euro. Das heißt: Die Hälfte aller Vorfälle bleibt darunter, die andere Hälfte liegt darüber. Soweit die intuitive Mitte.
Weil aber, in unserer Annahme, seltene Großschäden die Verteilung weit nach rechts ziehen, liegt der Durchschnitt nicht bei 100.000, sondern höher. Wir landen daher bei etwa 165.000 Euro für den Durchschnitt. Jetzt kommt der Teil, der unsere Intuition wirklich herausfordert: Über zwei Drittel aller Vorfälle, also rund 69 Prozent, liegen unterhalb dieses Durchschnitts. Der Durchschnitt ist also keineswegs der „mittlere“ Fall. Er ist ein Wert, den die klare Mehrheit der Vorfälle unterschreitet.
Woran liegt das? An den wenigen, sehr teuren Ausreißern. Ein einziger Vorfall mit einem Schaden von mehreren Millionen zieht den Durchschnitt spürbar nach oben, ohne den Median auch nur zu berühren. Der Median schert sich nicht darum, wie weit der teuerste Fall vom Rest entfernt liegt, sondern nur darum, wie viele Fälle es gibt. Der Durchschnitt ist empfindlich für Ausreißer, der Median ist es nicht. Bei einer rechtsschiefen Verteilung ist das kein Detail, sondern der ganze Unterschied.
Der Durchschnitt beschreibt damit weder den typischen Fall, denn der ist günstiger, noch die Katastrophe, denn die ist weit teurer. Er beschreibt einen Wert dazwischen, der aber in der Praxis selten genau eintritt und damit keine Aussagekraft für budgetwirksame Maßnahmen hat. Das ist der Sinn der eingangs paradox klingenden Behauptung: Der Durchschnitt ist eine Zahl, die fast nie passiert.
Und der lange Schwanz reicht weiter, als man denkt
Der eigentliche Ärger sitzt aber nicht beim Durchschnitt, sondern im Schwanz der Verteilung, dort, wo die echt teuren Ereignisse wohnen. Bei derselben Verteilung, deren Median bei 100.000 Euro liegt, liegt das 95. Perzentil, also der Wert, den nur einer von zwanzig Vorfällen überschreitet, dann bei rund 520.000 Euro. Das ist mehr als das Fünffache des typischen Falls.
Wer sein Notfallbudget, und damit seine Rücklagen oder seine Versicherungssumme am Durchschnitt ausrichtet, ist auf genau diese Ereignisse gar nicht vorbereitet, die ihn dann auch wirklich treffen werden. Denn diese Ereignisse, die eine Organisation ernsthaft gefährden, stehen nie beim Durchschnitt, sie stehen im Schwanz der Verteilung. Und den sieht man nur, wenn man in Perzentilen denkt anstatt in einfachen Mittelwerten.
Was Praktiker daraus mitnehmen
Die praktische Konsequenz ist unbequem, aber klar: Wer mit „durchschnittlicher Schaden plus/minus Standardabweichung“ arbeitet, plant an der Realität vorbei — nicht ein bisschen, sondern strukturell und immer in dieselbe Richtung, nämlich in Richtung Unterschätzung des Ernstfalls.
Die belastbaren Größen sind Perzentile. Statt „was kostet uns ein Vorfall im Schnitt?“ lautet die richtige Frage: „Welchen Schaden überschreiten wir mit 95-prozentiger Wahrscheinlichkeit nicht?“ Das ist eine Aussage, mit der man arbeiten kann. Eine die man gegen ein Budget halten kann, gegen eine Versicherungssumme prüfbar ist und gegen die Risikotragfähigkeit einer Organisation abgewogen werden kann. Ein Durchschnitt kann das alles nicht leisten, weil er die Form der Verteilung wegwirft: Aber genau auf die kommt es gerade an.
Genau hier setzen moderne Risiko-Quantifizierungs-Verfahren an: Sie modellieren Schäden als Verteilung, häufig als Lognormalverteilung oder Beta-PERT-Verteilung u.d.gl. und lesen das Risiko aus den Perzentilen und dem Schwanz ab und nicht aus dem Mittelwert. Das ist kein akademischer Luxus den man sich leisten sollte sondern es ist genau der Unterschied zwischen einer Zahl, die eine Entscheidung tragen kann, und einer, die nur so aussieht als hätte man informiert und zielgerichtet Entschieden.
Die ehrliche Grenze
Ich wäre nicht ehrlich, wenn ich die Lognormalverteilung als einzige und allwirksame Wahrheit verkaufen würde. Auch sie stellt nur ein Modell dar: Zwar ein deutlich besseres als die Glockenkurve, aber sie ist auch kein Naturgesetz.
Es gibt Cyber-Katastrophen, deren Schwänze noch schwerer sind, als die Lognormalverteilung vorherzusagen im Stande ist. Die wirklich extremen Ereignisse, die systemischen, die ganze Lieferketten oder Branchen gleichzeitig treffen, folgen mitunter eher einem Potenzgesetz, mit noch dickerem Schwanz. Für diese Klasse von Risiken ist selbst die Lognormalverteilung noch viel zu optimistisch. Das ist allerdings ein eigenes, tiefes Thema und gehört damit in einen späteren Beitrag noch gesondert behandelt. Es zeigt nur schon einmal, dass Cyber-Risk-Quantifizierung und Risiko-Entscheidungen auf entsprechende Szenarien gebaut werden sollte und mit den geeignetsten Modellen kombiniert betrachtet werden muss. Nur dann wird Cyber-Risk auch zur potentiellen Chance.
Aber als Startpunkt ist die Lognormal- der Normalverteilung weit überlegen. Und dieser eine Modellwechsel, weg von der symmetrischen Glockenkurve, hin zu einer rechtsschiefen Verteilung, entscheidet in der Praxis oft darüber, ob eine Risikozahl trägt oder betrügt. Man muss nicht das perfekte Modell haben. Man muss nur aufhören, das nachweislich falsche zu benutzen.
Ein Bild aus dem Alltag
Wer die Sache mit dem irreführenden Durchschnitt einmal im Kleinen sehen will, kann einmal außerhalb der Cybersicherheit nachsehen. Man stelle sich einen Raum mit fünfzig durchschnittlich verdienenden Menschen vor und rechne ihr mittleres Vermögen aus, das ist eine handhabbare, „typische“ Zahl. Nun betritt eine Milliardärin den Raum. Der Median, also das Vermögen der Person in der Mitte, ändert sich praktisch nicht: Es steht immer noch jemand ganz Normales in der Mitte der Reihe. Der Durchschnitt aber springt auf viele Millionen und beschreibt ab sofort tatsächlich niemanden mehr in diesem Raum. Nicht die fünfzig Normalverdiener, aber auch nicht die Milliardärin.
Genau das passiert in einem Portfolio von Cybervorfällen, nur ohne, dass jemand den Raum betritt: Die „Milliardärin“ ist der eine katastrophale Vorfall unter hunderten kleinen, und sie ist von Anfang an Teil der Verteilung. Der Durchschnitt trägt sie aber stets mit sich herum und wird dadurch zu einer Zahl, die den Normalfall maßlos überzeichnet und den Ernstfall maßlos untertreibt. Der Median ignoriert sie und beschreibt dafür ehrlich, was „typisch“ bedeutet.
Das ist keine Spitzfindigkeit, sondern der Grund, warum seriöse Einkommensstatistiken fast immer den Median berichten (sollten) und nicht den Durchschnitt. Wer bei schiefen Verteilungen den Durchschnitt nennt, sagt nichts Falsches aber er sagt etwas, das leicht falsch verstanden wird. In der Risikokommunikation ist das ein sehr gefährlicher Unterschied.
Was das für eine konkrete Entscheidung bedeutet
Machen wir den Unterschied an einer Entscheidung fest, die jeder Sicherheitsverantwortliche kennt: Wie hoch soll die Rücklage, oder die Deckungssumme einer Cyberversicherung, angesetzt werden?
Ein Team, das mit dem Durchschnitt plant, legt 165.000 Euro zurück und fühlt sich abgesichert: Man deckt ja „mehr als den erwarteten Schaden“ ab. Tatsächlich aber überschreitet jeder zwanzigste Vorfall die halbe Million: Das ist aber das Dreifache der getätigten Rücklage oder den Versicherungswert. Die Absicherung greift genau dann nicht, wenn sie gebraucht werden würde: nämlich im Ernstfall. Man hat für den häufigen Fall vorgesorgt, den man auch so verkraftet hätte, und für den seltenen, der wirklich wehtut, eben nicht.
Ein Team, das in Perzentilen denkt, stellt die Frage anders: Gegen welchen Anteil der Fälle wollen wir abgesichert sein? Sagen wir, gegen 95 Prozent. Dann ist die relevante Zahl nicht der Durchschnitt, sondern das 95. Perzentil und damit die rund 520.000 Euro. Die Rücklage fällt damit höher aus, aber sie ist an der richtigen Größe bemessen: an dem Schaden, den man mit hoher Wahrscheinlichkeit nicht überschreitet. Dieselben Daten, dieselbe Verteilung aber eine Entscheidung, die trägt, statt zu trügen.
Der Unterschied zwischen diesen beiden Teams ist kein Unterschied im Fleiß und keiner in den Daten. Es ist ein Unterschied darin, welche Zahlen sie aus derselben Verteilung herauslesen.
Und das ist die ganze Botschaft:
Die Verteilung enthält alle Information. Der Durchschnitt wirft sie weg.
Warum die Glockenkurve trotzdem überall steht
Man könnte sich nun fragen: Wenn die Normalverteilung für Schäden so offensichtlich unpassend ist, warum steht sie dann in so vielen Berichten? Die Antwort ist menschlich und ein bisschen unbequem.
Zum einen ist die Glockenkurve die Verteilung, die fast jeder in der Schule kennengelernt hat und oft auch die einzige. Sie ist der Standardgriff, das Werkzeug, das man nimmt, wenn man nicht weiter nachdenkt. Zum anderen verlangt sie wenig: zwei Zahlen, Mittelwert und Standardabweichung, und man hat scheinbar alles beschrieben. Das ist verführerisch bequem. Eine Verteilung, die man ernst nimmt, verlangt mehr: Perzentile, eine Vorstellung vom Schwanz, ein Modell für die Entstehung.
Und schließlich gibt es einen subtilen Denkfehler: Weil die Standardabweichung eine „Streuung“ misst, glauben viele, sie hätten die Unsicherheit damit erfasst. Bei einer symmetrischen Verteilung stimmt das auch. Bei einer rechtsschiefen führt die Standardabweichung sogar noch zusätzlich in die Irre denn „Durchschnitt minus eine Standardabweichung“ kann in einen negativen Schaden führen, den es gar nicht geben kann, während „plus eine Standardabweichung“ den wahren Schwanz immer noch dramatisch unterschätzt. Die vertraute Kennzahl beschreibt eine Symmetrie, die so schlicht nicht existiert.
Die Glockenkurve steht also nicht deshalb überall, weil sie passt, sondern weil sie einfach ist und niemand die Annahme hinterfragt. Das ist genau die Sorte stillschweigender Voreinstellung, die sich aber eine belastbare Risikoanalyse so nicht leisten kann.
Woher wir das wissen
Nichts an diesen Argumenten ist eine Meinung. Dass ein multiplikativer Prozess zur Lognormalverteilung führt, ist ein bewiesener Satz. Dass bei einer rechtsschiefen Verteilung der Durchschnitt über dem Median liegt, folgt zwingend aus ihrer Form. Und dass bei einer Lognormal-Verteilung und den genannten Zahlen rund 69 Prozent der Fälle unter dem Durchschnitt liegen, ist keine Schätzung, sondern ein nachrechenbares Ergebnis. Jeder, der die Verteilung so ansetzt, kommt auf dieselben Werte.
Das ist der Punkt: Die Aussage „der Durchschnitt tritt fast nie ein“ ist nicht meine Behauptung, sondern die Konsequenz einer Annahme, die man offenlegen und prüfen kann. Wer sie bestreitet, muss die Annahme bestreiten, dass Schäden multiplikativ entstehen und nicht das Ergebnis. Und über diese Annahme lässt sich reden, mit Daten, an einer präzisen Stelle.
Die gefährlichste Zahl in einem Risikobericht ist ein Durchschnitt ohne die Verteilung dahinter.
Wie modelliert ihr eure Schadenshöhen? Noch mit Punktschätzungen oder schon mit ganzen Verteilungen?